앤트로픽이 2026년 9월 28일 클로드 소넷 5.5를 내놓으면서, 오퍼스 5.5처럼 이전 세대보다 글을 더 분명하게 쓴다고 소개했어요.
그런데 그보다 닷새 전에는 클로드 파인튜닝을 맡은 앤트로픽 직원 Jackson Kernion이 X에 오퍼스 4.6이 마지막으로 좋은 글쓰기 모델이었다고 적었다는 보도가 나왔어요.
보도에 따르면 그는 최근 모델들이 수학과 코드, 그리고 다른 AI가 읽을 설명에 맞춰 훈련되면서 사람에게는 지나치게 빽빽한 글을 쓰게 됐다고 설명했고, 오퍼스 5.5는 4.6 이후 가장 만족스럽다고 했다고 해요.
소넷 5.5 글쓰기 실력이 정말 나아졌는지는 결국 같은 요청으로 직접 비교해봐야 알 수 있을 것 같았어요.
같은 요청 세 가지를 다섯 모델에 보내고, 이름을 가린 채 골랐어요
비교한 모델은 소넷 5와 5.5, 그리고 오퍼스 4.6·5·5.5예요.
오퍼스 4.6은 Kernion이 기준으로 든 모델이라 함께 넣었어요.
요청은 평소 AI에게 자주 맡길 법한 세 가지로 정했어요.
- 팀장님께 다음 주 회의를 화요일에서 목요일로 옮겨달라고 요청하는 메일
- 개발자가 아닌 동료에게 프롬프트 캐싱이 뭔지, 왜 비용이 줄어드는지 설명하기
- 처음 등산 가는 친구에게 준비물과 주의사항 알려주기
두 번째 요청의 프롬프트 캐싱은 예전에 용어 정리 글에서 다룬 개념이에요.
요청마다 모델별로 세 번씩 API로 보냈고, 시스템 프롬프트 없이 각 모델의 기본 설정을 그대로 썼어요.
그다음 어느 모델이 쓴 글인지 모르게 A~E로 가리고 순서를 섞어서, 제가 읽기 편하고 그대로 쓸 만한 순서로 1위부터 5위까지 매겼어요.
평가에는 결과를 보기 전에 정해 둔 규칙대로 1회차와 2회차 결과물만 썼고, 3회차는 글자 수나 문장 길이 같은 기계 측정의 평균을 낼 때만 포함했어요.
그래서 요청 세 가지에 평가 두 번씩, 순위가 모두 여섯 번 나온 셈이에요.
2회차는 1회차 모델 정답이 공개된 뒤에 평가했고 1회차 순위 결과는 보지 않았지만, 모델명을 다시 가렸어도 완전히 독립된 블라인드 평가라고 보기는 어려워요.
다만 A~E 배치 순서는 회차마다 다르게 섞었어요.
솔직히 다 고만고만해서 순위를 매기기가 쉽지 않았거든요.
그런데 정답을 맞춰보니 오퍼스 4.6이 여섯 번 중 다섯 번 1위였고, 나머지 한 번도 2위였어요.
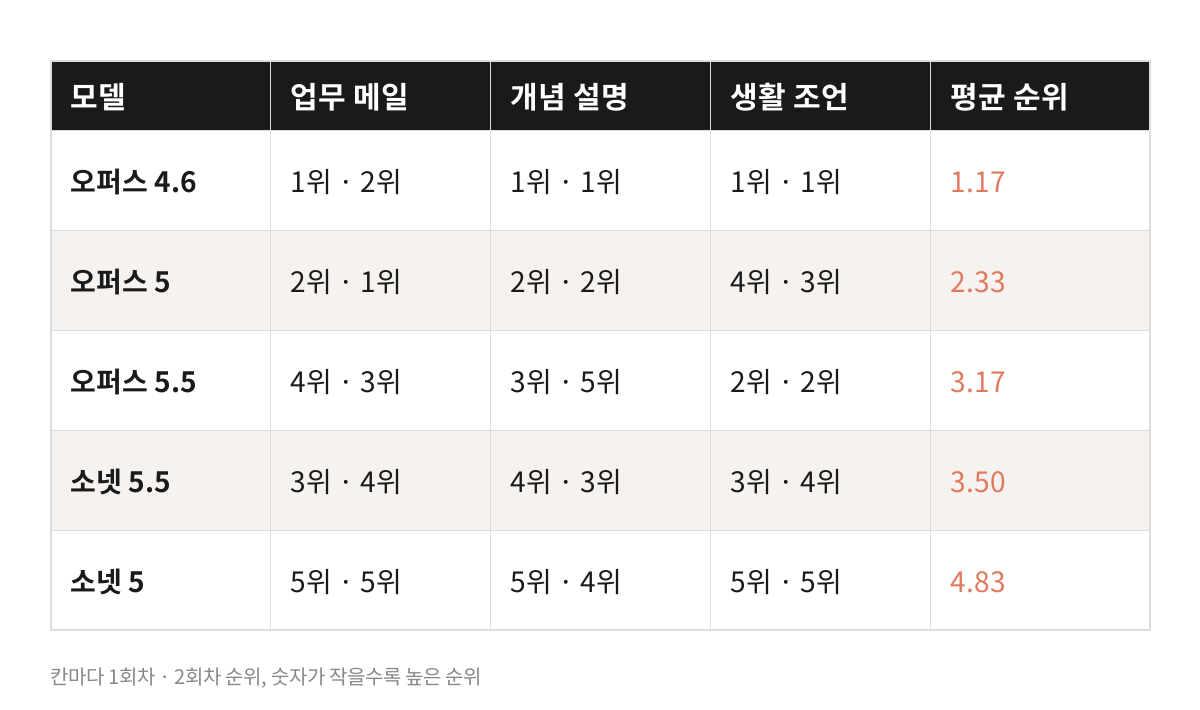
소넷 5.5는 여섯 번 모두 소넷 5보다 위여서, 앤트로픽이 밝힌 개선 방향과는 맞는 결과예요.
반면 오퍼스 5.5가 오퍼스 5보다 위였던 건 여섯 번 중 두 번뿐이었어요.
제 평가 기준과 모델별 기본값이 결과에 섞였을 가능성도 따져봤어요
결과만 보면 오퍼스 4.6이 글을 제일 잘 쓴다고 말하고 싶어지는데, 숫자를 다시 보니 걸리는 게 있었어요.
순위를 매긴 뒤 다섯 모델의 여섯 번 평가 평균만 놓고 가볍게 비교해보니, 제가 높게 둔 답변일수록 대체로 더 길었고 굵은 글씨도 더 많이 썼어요.
다만 비교 단위가 다섯 모델뿐이라, 그게 순위를 높인 원인이라고 말할 수는 없어요.
가장 짧게 쓴 소넷 5가 거의 매번 꼴찌였는데, 메일 기준으로 평균 248자라 다른 모델(약 430~520자)의 절반 정도였어요.
그래서 이번 결과가 더 잘 쓴 글을 고른 건지, 더 많이 쓴 글을 고른 건지는 깔끔하게 나눠 말하기 어려워요.
Kernion이 말한 빽빽함은 개념 설명 요청에서만 비슷하게 보였어요.
코드로 잰 평균 문장 길이로 보면 오퍼스 4.6은 22자 남짓이었는데, 오퍼스 5.5는 33자, 소넷 5는 36자 정도였거든요.
평가할 때도 프롬프트 캐싱을 설명하면서 비유와 서술을 길게 늘어놓는 글이 몇 개 눈에 띄었어요.
메일과 등산 조언에서는 이런 차이가 뚜렷하지 않았고요.
요청 내용과 최대 출력 토큰은 같게 뒀지만 모델별 기본 동작은 달랐어요.
기본 설정에서 API 응답에 thinking 블록이 들어온 건 오퍼스 4.6이 9건 중 0건, 오퍼스 5와 5.5가 9건 모두, 소넷 5가 3건, 소넷 5.5가 6건이었어요.
사고 수준(effort) 기본값도 오퍼스 5.5만 medium이고 나머지는 high예요.
그래서 이번 비교는 각 모델의 기본 상태를 그대로 놓고 본 결과예요.
평가자도 저 한 명이고, 한국어 요청 세 가지를 앱이 아닌 API로 돌린 결과라 “항상 이렇다”고 말할 수는 없어요.
오퍼스 5의 effort 설정별 벤치마크를 정리했을 때도 가장 높은 설정이 늘 정답은 아니었는데, 이번에도 가장 새 모델이 늘 앞서지는 않았어요.
새 모델이 나오면 습관처럼 갈아타게 되지만, 글쓰기만큼은 자주 시키는 요청 몇 개로 직접 비교해볼 만하다는 생각이 들었어요.
AI에게 글을 맡길 때, 같은 요청을 다른 모델에 넣어 비교해보신 적 있으신가요?