글을 쓸 때 AI로 초안을 다듬다 보면, 뭔가 어색하다고 느껴지는 순간이 자주 있어요. 콕 집어 뭐가 문제인지는 모르겠는데, 문장 어딘가 붕 떠 있는 느낌이요.
그 어색함, 감이 아니라 근거가 있었어요.
퓨 리서치센터가 영어 웹페이지 약 49만 개를 분석해서 확인한 내용이거든요.
AI 탐지 비율이 뚜렷하게 늘었어요
Common Crawl 아카이브에서 뽑은 페이지들을 AI 탐지 도구 Open Pangram으로 검사한 결과예요.
예전에 저도 이 도구로 사람 글과 AI 글을 직접 구분해본 적이 있는데, 판정은 같아도 확신도가 다르게 나온 적이 있었어요.
2026년 7월 기준으로 보면 전체 페이지의 약 10%가 뚜렷한 AI 작성 흔적을 보였어요.
그런데 챗지피티(ChatGPT)가 나온 2022년 11월 이후에 발행된 페이지만 따로 골라보면 이야기가 달라져요. 이 비율이 3분의 1을 넘어가거든요.
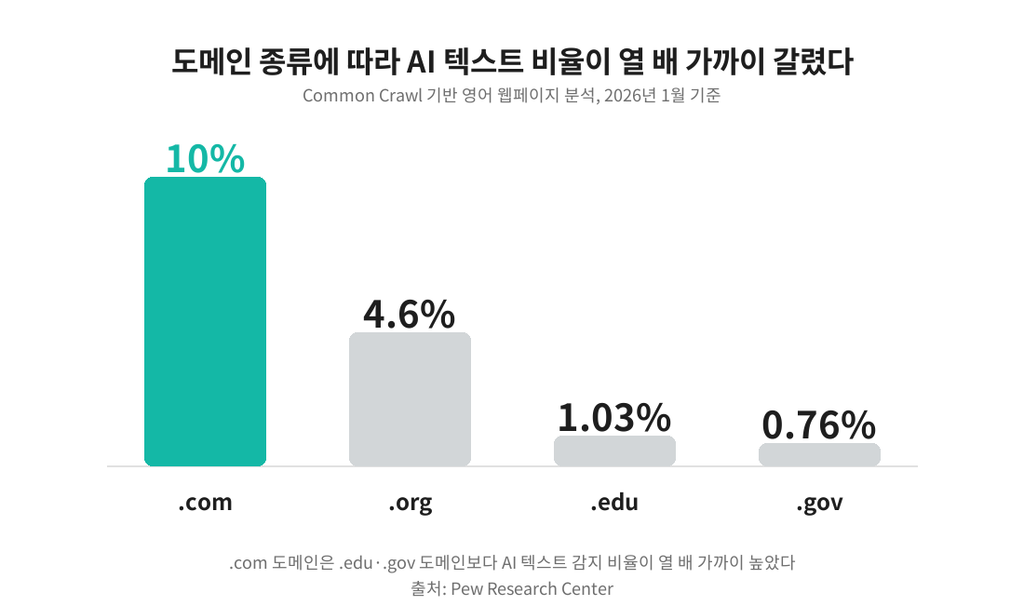
2026년 1월 기준으로 보면 사이트 종류별 차이도 컸어요. .com 도메인은 10%인데 .org는 4.6%, .edu와 .gov는 각각 1% 안팎이었어요.
.com 도메인에서 감지된 비율이 .edu·.gov 도메인보다 열 배 가까이 높았던 거예요.
표현 습관에서도 변화가 뚜렷했어요.
긴 줄표(em dash) 사용은 2023년 대비 약 2배 늘었고, 옥스퍼드 콤마 사용은 63% 늘었어요.
Pew가 정리한 단어는 이보다 많은데, 그중 일부만 적어볼게요.
- delve, interplay, testament, pivotal, landscape
- tapestry, bolstered, crucial, meticulous, vibrant
이런 단어들의 사용 빈도는 2023년보다 전체적으로 2배 넘게 늘었어요.
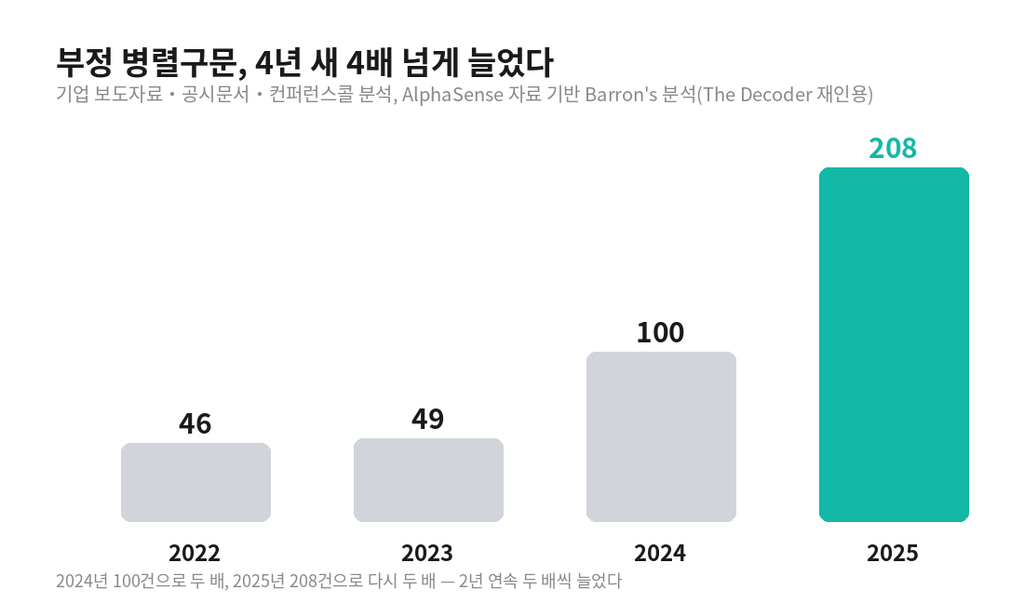
문장 패턴도 있어요. “이건 그냥 X가 아니라 Y다” 같은 부정 병렬구문의 사용이 거의 3배로 늘었어요.
절대 빈도로는 여전히 드물지만, 늘어난 방향은 뚜렷해요. 비슷한 흐름은 기업 문서에서도 나타났어요.
The Decoder가 AlphaSense 자료를 바탕으로 한 Barron’s 분석을 인용해 전한 내용에 따르면, 이 표현이 보도자료·공시 문서에서 2022년 46건에서 2025년 208건으로 네 배 넘게 늘었어요.
이 표현 썼다고 AI가 쓴 건 아니에요
여기서 짚고 넘어가야 할 게 있어요.
다만 이 수치를 실제 AI 작성 비율로 그대로 읽기는 어려워요.
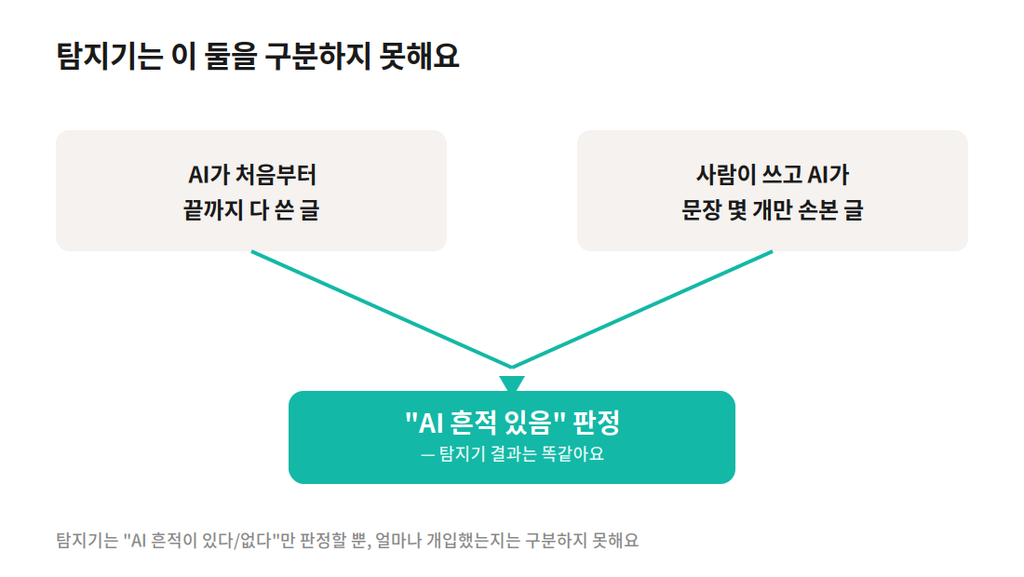
AI가 처음부터 끝까지 다 쓴 글부터, 사람이 쓴 글에 AI가 문장 몇 개만 손댄 경우까지 전부 이 범주에 들어가거든요. 탐지 도구가 이 차이를 정확히 구분하지 못해요.
특히 문체를 흉내 낸 글 앞에서는 탐지기 정확도가 눈에 띄게 떨어진다는 연구 결과도 있어요.
즉 “delve”라는 단어를 썼다고 그 글이 AI가 쓴 글이라는 뜻은 아니에요. 이 단어들은 원래도 존재하던 표현이고 사람도 얼마든지 써요.
정확히 말하면 이 연구가 보여주는 건 탐지 도구가 AI 흔적이 있다고 판정한 글에서 이 표현들이 유독 자주 나타났다는 경향이지, “이 표현을 쓰면 AI가 쓴 걸로 들킨다”는 확정된 공식은 아니에요.
그래도 이 경향 자체는 참고할 가치가 있어요.
임페리얼칼리지런던·인터넷 아카이브·스탠퍼드대 연구진이 참여한 2026년 4월 연구에서도 탐지 도구로 신규 웹사이트를 분석한 결과, 약 35%가 전체 또는 부분적으로 AI가 작성한 텍스트로 분류됐다는 비슷한 결론이 나왔어요.
이 연구에선 AI로 분류된 텍스트끼리 의미적 유사성이 AI로 분류되지 않은 텍스트보다 33% 더 높았고, 인위적으로 밝은 어조를 보이는 경향도 확인됐어요.
정형화된 표현을 줄이는 점검법이에요
여기서부터는 AI 티 나는 표현, 어떻게 점검하면 좋을지 정리해볼게요.
다만 여기서 하나는 짚고 가야 해요.
위 단어 목록은 전부 영어 표현이에요. 한국어로 글을 쓰신다면 이 단어 자체를 세어보는 건 큰 의미가 없어요.
그 대신 단어보다 원리를 가져오는 게 나아요. 초안 전체에서 유독 반복되는 연결 표현이나 마무리 문장이 있는지 스스로 훑어보는 습관이요.
“단순히”, “결국”, “중요한 건”, “핵심은 A가 아니라 B다” 같은 틀이 특정 문단마다 계속 나온다면, 그것도 정형화된 표현일 수 있어요.
반면 영어로 이메일이나 이력서, 문서를 AI로 쓰거나 다듬는 경우라면 이 열 개 단어는 그대로 체크리스트로 쓸 수 있어요.
완성 후에 이 단어들이 유독 반복되거나 문장을 추상적으로 만들어놓은 곳이 있는지 훑어보면 좋아요.
그리고 그런 곳이 있다면 “a pivotal moment”처럼 두루뭉술한 표현 대신, 실제로 무엇이 어떻게 바뀌었는지를 구체적으로 적어보는 쪽이 나아요.
훨씬 구체적이고 읽는 사람 입장에서도 와닿거든요.
em dash나 “이건 그냥 X가 아니라 Y다” 같은 문장 구조도 마찬가지예요. 한두 번은 괜찮지만, 한 편의 글에 반복해서 나온다면 한 번은 다르게 표현해볼 만해요.
목적은 AI 탐지를 피하는 게 아니에요. 내가 실제로 하려던 말이 정형화된 표현 뒤에 묻히지 않게 하는 것에 더 가까워요.
여러분이 최근에 AI로 다듬은 글에도, 이런 표현이 섞여 있진 않나요?